사람이 승인한 AI 답이 질문을 놓친 이유, 그리고 관문
사람이 승인한 AI 댓글 12건을 다시 채점해 보니, 질문에 맞는 정도가 5점 만점에 2.0점이었어요.
요약
- 사실 확인과 사람 승인만으로는 엉뚱한 답을 막지 못했어요
- 그래서 “지금 데이터로 답할 수 있는 질문인가”를 올리기 전 관문으로 옮겼어요
- 관문을 건 뒤 다시 본 후보 중 통과한 글은 없었어요
10월 24일 GTM 해커톤에서 커뮤니티 질문에 답하는 에이전트를 2시간 만에 만들어 1위를 했어요. 이 글은 그 뒤 7일 동안 직접 운영하며 드러난 실패와 고친 과정이에요.
공유 링크를 따라가니 커뮤니티가 있었어요
행사에서 받은 상은 OpenAI가 후원하는 API 크레딧 1만 5천 달러였어요. 에이전트 코드와 7일 운영 기록은 공개 저장소(reevl-gtm-loop)에 있어요.
해커톤 전에 먼저 유입을 들여다봤어요. 10월 24일 조회 기준으로 리블 세션의 95.5%는 네이버 출처였고, 네이버 밖에서 오는 세션은 거의 없었어요. 그런데 눈에 띄는 숫자가 하나 있었어요. 공유된 비교 화면에서 시작한 세션은 세션당 7.05페이지를 봤고, 사이트 평균은 2.57페이지였어요. 다만 비교 링크를 스스로 고른 사람들이라 깊게 보는 게 어느 정도 당연한 집단이에요.
그 링크가 어디서 왔는지 따라가 보니 비교 화면 착지의 약 3분의 1이 커뮤니티 글에서 왔어요. 누군가 단지를 두고 고민하는 글에, 다른 누군가가 근거로 리블 비교 링크를 붙인 거예요. 정작 리블에는 공유를 세는 장치가 단지 화면 하나에만 있어서, 이런 흐름이 있는 줄도 몰랐어요. 그래서 이미 묻고 있는 사람에게 먼저 답해 보기로 했어요. 아이디어는 다섯 개였지만, 나머지 넷은 모두 리블 서비스를 고쳐 배포해야 해서 7일 안에 돌릴 수 없었어요.
답을 만드는 일과 답해야 하는지 고르는 일을 나눴어요
가장 오래 고민한 건 올리는 방식이었어요. 관계를 숨기면 클릭은 더 나올 수도 있지만, 그러면 커뮤니티가 리블 링크를 믿어 주는 마음을 걸어야 해요. 그래서 리블과의 관계는 매번 밝히고, 자동으로 올리지 않고 사람이 한 건씩 승인했어요. 결과는 관계 공개 12/12, 사람 승인 12/12였어요. 다만 이건 절차를 지켰다는 기록이지 답의 질을 보증하는 숫자는 아니었어요.
양을 처음부터 잘 제한한 것도 아니었어요. 10월 30일 하루에 7건을 올린 뒤 도배로 보일 위험이 커졌다는 걸 알았고, 그날 커뮤니티별 하루 2건·최소 20분 간격·같은 링크 재사용 금지 장치를 넣었어요. 이 장치는 우리 쪽 상한일 뿐, 커뮤니티 규칙을 지켰다는 보장은 아니에요. 운영 기간에 원글 1건이 삭제됐고, 그 이유는 확인하지 못했어요.
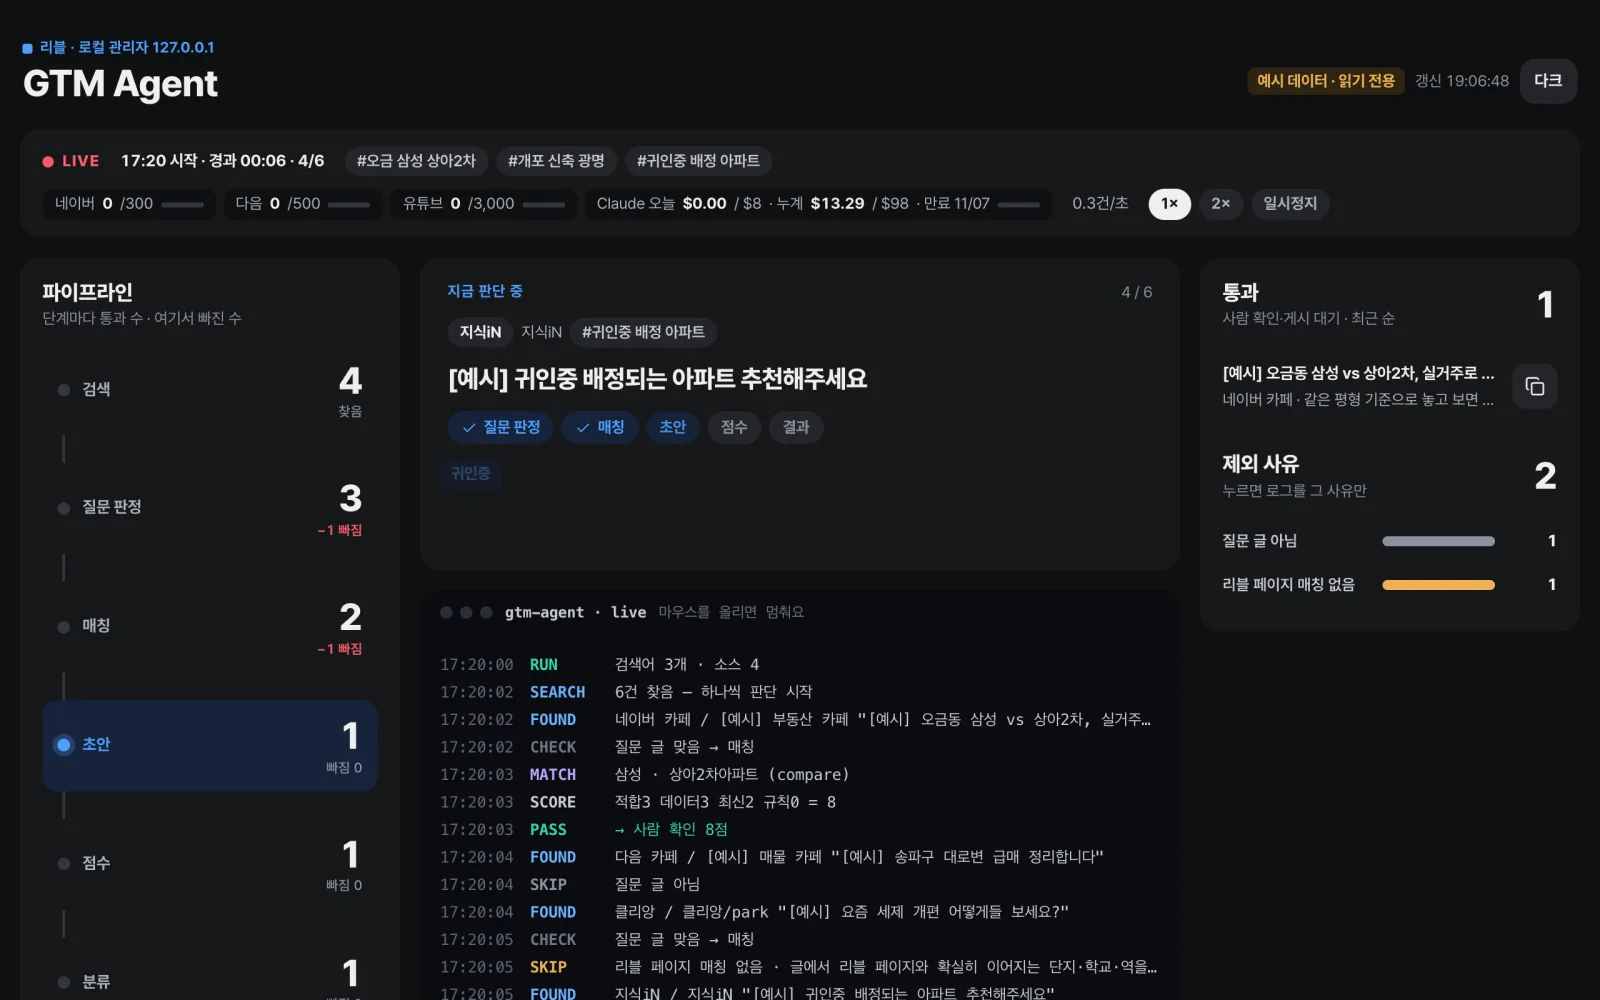
루프 기록은 31회차까지 쌓였어요. 검수가 글 요약(약 200자)만 보고 틀린 답을 통과시킨 적이 있어서, 원문과 기존 댓글까지 읽고 두 모델이 따로 판정하게 바꿨어요. 그 뒤 내부 평가 세트(20건, 2회 실행)에서 오답 34/34를 막았고, 맞는 답은 5/6을 통과시켰어요(맞는 답 사례가 3건뿐이라 오차를 넓게 봐야 해요). 단지 이름을 다르게 적은 질문도 알아보게 고쳐서, 사람이 확정한 6건 중 4건을 스스로 맞혔어요. 쓴 AI 비용은 약 $12였어요(인건비·인프라 제외).
사람이 다 승인했는데, 답의 질은 낮았어요
방문 수보다 더 궁금했던 건 답의 질이었어요. 10월 30일까지 올린 댓글 중 10건을 여섯 가지 항목으로 다시 채점했어요. 채점도 AI(Opus)가 했고 같은 계열 모델이라 독립된 검증은 아니에요. 채점 지시에 “엄격하게 채점한다”는 문장이 있어서 점수가 낮게 나왔을 가능성도 있어요.
질문 적합성
후속 대응 가능성
실거래 근거
정확성
비광고성
자연스러움
가장 낮은 건 질문 적합성 2.0/5였어요. “어디가 나아요?”라는 질문에 실거래 두 줄과 링크만 답한 경우가 많았거든요. 자연스러움은 3.0/5로 질문 적합성보다 높았지만, 이것만으로 좋은 답이라고 보기는 어려웠어요. 문제는 숫자를 지어내는 것만이 아니었어요. 지어내지 않은 실거래를 가져왔어도 질문에서 중요한 것이 무엇인지 놓치면 답은 쓸모없어질 수 있었어요.
그럼 사람은 왜 승인했을까요? 지금 남은 기록만으로는 답할 수 없어요. 당시 승인자가 무엇을 주로 봤는지(사실 정확성인지, 관계 공개인지, 질문 대응인지) 체크리스트로 남기지 않았거든요. 우리는 사실 오류를 막는 데 검수를 집중하느라 “질문에 닿았는가”를 약하게 봤다고 의심해요. 확인된 원인은 아니에요.
사후 평가를 게시 전 관문으로 옮겼어요
그래서 같은 채점표를 게시 전에 돌려, 질문 적합성이 3점보다 낮으면 올리지 않는 관문을 걸었어요. 관문을 건 뒤 다시 본 후보 42건 중 통과는 0건이었어요. 탈락 사유는 대부분 추천이나 전망, 재건축 절차처럼 실거래 두 줄로 답하기 어려운 질문이었어요. 그 뒤에도 2점짜리 1건을 운영자 승인으로 예외 게시했어요. 사람 승인이 관문을 넘어설 수 있다는 것도 이때 알았어요.
이 결과는 답변 생성 능력보다 질문의 적합성과 데이터 범위를 먼저 확인해야 한다는 가설을 강하게 만들었어요. 그래도 결론은 아니고, 다른 설명이 셋 남아 있어요.
- 수요 문제: 실거래로 직접 답할 수 있는 질문이 원래 적었을 수 있어요.
- 데이터 범위 문제: 추천·전망·주변 생활 질문을 뒷받침할 자료가 부족했을 수 있어요.
- 검수 문제: 3점 관문이 지나치게 보수적이거나 모델 채점이 부정확해 괜찮은 답도 떨어졌을 수 있어요. 답할 만한 질문을 얼마나 버렸는지는 재지 않았어요.
“답을 잘 쓰는 것보다, 이 질문에 지금 가진 데이터로 답할 수 있는지를 먼저 묻는 게 필요했어요.”
방문 결과는 따로 적어요
측정 설계에도 실수가 있었어요. 목표는 “네이버 밖 신규 유입”이었는데, 네이버 카페에서 온 세션은 네이버 출처로 잡혀서 이 목표에는 처음부터 들어갈 수 없었어요. 실제로 연 유입 경로를 세려면 검색 유입과 커뮤니티에서 온 방문을 가르는 분류, 그리고 끝까지 지워지지 않는 출처 표시가 먼저 필요했어요. 같은 기간 사이트 전체 세션도 늘었지만 대부분 네이버 검색 몫이라 성과로 세지 않았어요.
원글이 하루 만에 삭제된 첫 댓글은 그 뒤로 링크 방문이 관찰되지 않았어요. 글이 남아 있는지가 유입에 영향을 줄 수 있다는 단서였지만, 한 건만으로 일반화할 수는 없어요.
지금은 규칙이 이 결정을 지켜요
바깥으로 나가는 글은 지금도 사람이 승인한 뒤에만 나가요. 리블 팀 운영에서도 게시와 외부 발송은 대표 승인 뒤 허브가 공식 API로만 하고, 블로그 자동 게시는 꺼 두었어요.
다음에 잴 것
다음 목표는 게시 수를 늘리는 게 아니에요. 이 질문에 지금 가진 데이터로 책임 있게 답할 수 있는가를 먼저 분류하고, 답하기 어려우면 올리지 않는 기준을 검증하려고 해요. 해커톤 기능은 리블 본체에 배포되지 않았고, 아래는 아직 하지 않은 계획이에요.
- 같은 댓글 10건을 사람 판단자 2명이 같은 채점표로 따로 매긴 점수와 모델 점수의 일치도
- 관문 임계값(2·3·4점)마다 버려지는 “답할 만한 질문”의 건수
- 비교 화면 공유를 직접 세는 장치와 지워지지 않는 출처 표시로 잰 실제 공유 경로 - 지금은 추정 귀속
숫자 출처
리블 팀이 만드는 과정을 기록한 글이에요. 숫자는 글을 쓴 시점 기준이고, 화면은 그 뒤에 바뀔 수 있어요.