검사를 다 통과한 AI 검색을 다시 재 본 이유
검사는 다 통과했는데, 결과 단지를 다시 재 보니 95문장 중 63문장만 맞았어요.
요약
- 실력은 고치는 데 쓰지 않은 처음 보는 문장 묶음으로만 재요
- 결과가 없으면 조건을 몰래 풀지 않고 없다고 말하게 바꿨어요
- 회귀 점수가 조금 떨어지는 쪽을 골랐어요
리블 AI는 “마포 8억 이하 국평” 같은 말을 조건으로 바꿔 단지를 찾아 주는 기능이에요. 출시 전에 그 결과를 처음부터 다시 쟀어요.
나온 단지를 직접 열어 봤어요
말 한 줄로 찾는 만큼, 말을 잘못 알아들으면 사람은 틀린 목록을 맞는 목록으로 믿게 돼요. 이 글은 출시 전 리블 AI의 오프라인 평가 기록이에요.
63/95
결과 단지로 다시 잰 문장 · 10/16, 고치기 전
93/95
고친 뒤 같은 문장 · 같은 날 밤 - 실력 숫자 아님
78/100
학습용 문장 쌍 1차 사람 검수 승인 · 기준 98 이상 - 미달
10월 16일, 질문을 하나씩 넣어 봤어요. 그때까지 돌리던 검사는 전부 통과 중이었는데, 결과에는 이상한 답이 섞여 있었어요. “래미안 말고”라고 하면 래미안만 남았고, “광주 30평대”는 광주광역시가 아니라 경기 광주시로 읽었어요. “9억 초 대단지”는 9억 이하로 읽었고요.
우리는 원인을 검사가 던지는 질문에서 찾았어요. 기존 검사는 말에서 조건이 잡혔는지만 봤고, 그 조건이 빼라는 뜻인지 넣으라는 뜻인지는 묻지 않았어요. 그러니 “래미안”이 조건으로 잡히기만 하면 통과였어요. 조건이 맞게 잡혀도 결과는 틀릴 수 있다는 걸 그날 제대로 알았어요.
채점은 검색과 따로 읽어요
그래서 결과를 채점하는 장치(판정기)를 만들었어요. 검색이 돌려준 단지마다 원자료를 다시 열어, 말과 어긋나는 단지가 섞였는지 세는 방식이에요. 이때 판정기는 문장을 처음부터 혼자 읽어요. 검색의 해석을 빌려 오면, 검색이 틀린 곳에서 채점도 똑같이 틀리기 때문이에요.
이 장치로 다시 재자 95문장 중 63문장만 맞았어요. 같은 날 밤 잘못 읽던 부분을 고쳐 93문장이 됐어요. 하지만 이 숫자를 실력이라고 부를 수는 없었어요. 틀린 문장을 보고 바로 고쳤으니, 맞히는 게 당연한 문제였거든요.
시험 문제는 미리 보지 않아요
고친 문장 묶음(회귀 셋)은 되던 게 아직 되는지만 알려 줘요. 실력은 처음 보는 문장 묶음(홀드아웃)으로 따로 재요. 여기서 틀린 문장은 고치지 않고, 실패의 종류만 센 다음 새 문장으로 다시 재요.
홀드아웃은 셋으로 나눴어요. 개발에 쓴 것과 같은 문장 틀(E1, 418문장), 개발에 안 쓴 시군구(E2, 206문장), 그리고 다른 모델이 말투를 바꿔 쓴 문장(E3, 211문장)이에요. 채점도 엄격하게 바꿔서, 가격 조건을 조금 넘는 단지나 일부만 맞는 답을 봐주지 않게 했어요. 그 전 점수는 대외 숫자로 쓰지 않아요.
같은 문장 틀(E1)
78.9 → 81.6
처음 보는 시군구(E2)
83.0 → 88.3
다른 모델이 바꿔 쓴 말투(E3)
66.8 → 69.7
다른 모델이 바꿔 쓴 말투가 가장 낮아요. 우리 규칙이 가장 덜 본 말투라서, 낯선 표현에 약하다는 뜻으로 읽어요. 그래도 점수를 올리려고 그 문장들을 들여다보지는 않았어요. 들여다보는 순간 이 묶음도 미리 본 시험 문제가 되니까요.
0곳을 몰래 채우고 있었어요
사람 검수에서는 오래된 동작 하나가 드러났어요. 자체 모델 학습에 쓰려던 문장 쌍 표본 100건 중 78건만 승인됐는데(기준은 치명 오류 0, 승인 98% 이상), 검수자는 시스템이 무엇으로 읽었는지를 보고 판정했어요. 그러다 결과가 0곳일 때 검색이 가격 같은 조건을 덜어 내고 가까운 단지로 목록을 채운다는 게 보였어요. 0곳 화면을 줄이려고 8월에 넣어 둔 동작이었어요.
사용자는 이걸 알 수 없어요. “8억 이하”라고 했는데 9억 단지가 나오면, 사람은 그걸 8억 이하로 믿을 수 있어요. 조건을 바꾼 건 시스템인데, 그 결과를 믿고 움직이는 건 사람이에요. 그래서 출시 전 브랜치에서 이 동작을 껐고, 필수 조건은 시스템이 바꾸지 않는다는 걸 규칙으로 정했어요. 지금 운영 중인 검색에는 옛 동작이 아직 남아 있어요.
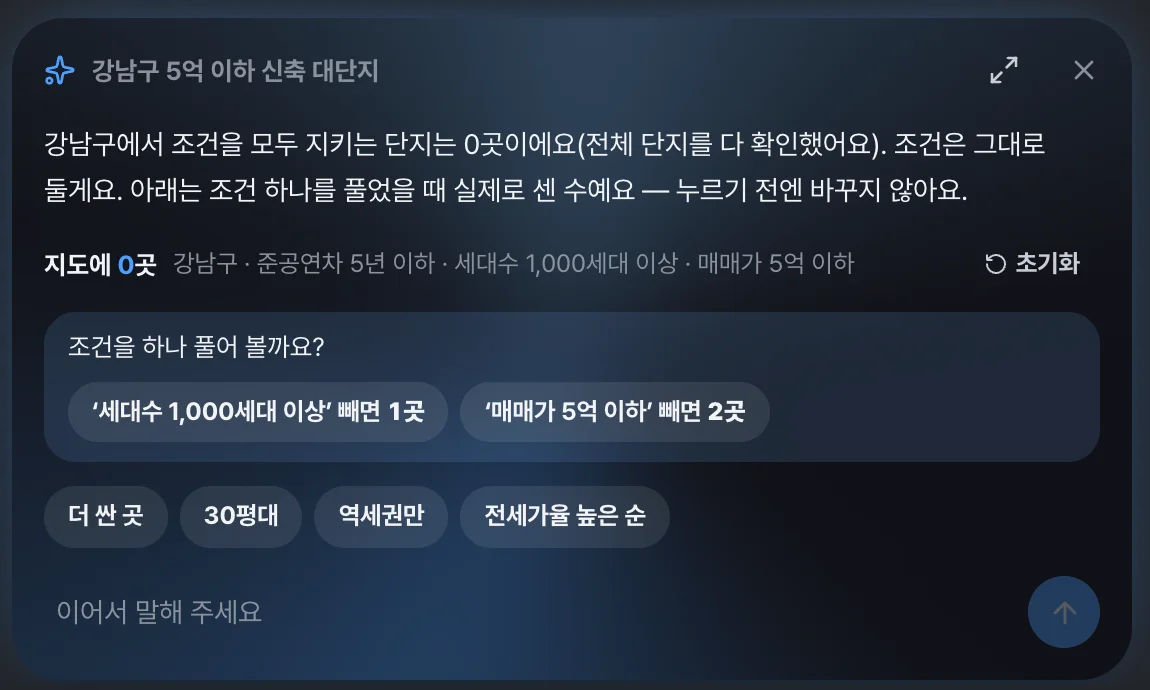
대신 0곳이라고 말할 때도 이유를 나눠요. “없다”와 “확인하지 못했다”는 찾는 사람에게 전혀 다른 말이라서, 아래 네 가지로 구분해 보여 줘요.
- 다 확인했는데 없어요
- 자료가 빈 단지는 확인하지 못했어요
- 함께 만족할 수 없는 조건이에요
- 그 조건의 자료가 아직 없어요
넓히기는 제안만 해요. 조건을 하나 뺐을 때 실제로 몇 곳이 나오는지 세어서 보여 주고, 사용자가 누를 때만 조건이 바뀌어요. 가격을 조금 넓힐지 세대수를 포기할지는 찾는 사람이 정할 일이니까요.
점수가 떨어지는 쪽을 골랐어요
몰래 채우기를 끄자 회귀 셋 점수가 354에서 349로 내려갔어요. 채점을 느슨하게 고치면 바로 돌아오지만, 그러지 않았어요. 점수를 지키려고 채점을 검색에 맞추면, 판정기를 따로 둔 이유가 사라지니까요.
대신 무엇이 어긋났는지 파고들었어요. 검색이 “역세권”이나 “학군”을 채점보다 엄격하게 정의하고 있어서, 둘이 같은 정의값을 읽게 했어요. 그러자 숨어 있던 해석 버그가 나왔어요. “대형마트”의 ‘대형’을 큰 평수로 읽는 식이었고, 이런 것들을 고친 뒤 354로 돌아왔어요.
같은 시기에 말을 다시 쓰는 작은 모델을 직접 학습하는 연구도 했어요. 시작 전에 합격선(처음 보는 말투 묶음에서 +5%p)을 먼저 적어 두었는데, 학습으로 얻은 이득은 약 2%p였어요. 같은 기간 규칙을 한 번 고친 이득(+2.7~3.4%p)보다 작아서 학습을 멈췄어요.
“모델을 키우는 것보다, 무엇을 틀렸는지 정확히 재는 쪽이 더 많이 올렸어요.”
지금은 규칙이 이 결정을 지켜요
실사용 점검에는 의미 판정을 넣는다는 규칙을 상설로 두었어요. 기계 판정만으로는 명백한 오답을 놓친다는 걸 이 평가에서 확인했기 때문이에요. 리블의 LLM 호출은 상한이 있는 한 곳으로만 하고, 다른 유료 제공자로 몰래 넘어가지 않게 했어요.
다음에 잴 것
아직 모르는 게 많아요. 0곳을 만난 사람이 넓히기를 누르는지, 그냥 떠나는지 보려고 기록 장치는 미리 심어 두었어요. 출시 뒤에 같은 정의로 볼 지표는 세 가지예요.
- 리블 AI 질문 중 0곳으로 끝난 비율과, 그중 넓히기 제안을 누른 비율
- 0곳 뒤 다음 행동(단지 열기·다른 질문) 대 이탈
- 새 표본으로 다시 본 사람 검수 관문(치명 0, 승인 98% 이상) 통과 여부
숫자 출처
리블 팀이 만드는 과정을 기록한 글이에요. 숫자는 글을 쓴 시점 기준이고, 화면은 그 뒤에 바뀔 수 있어요.